PixelDiT2 ma zwiększyć kontrolę nad obrazami generowanymi przez AI
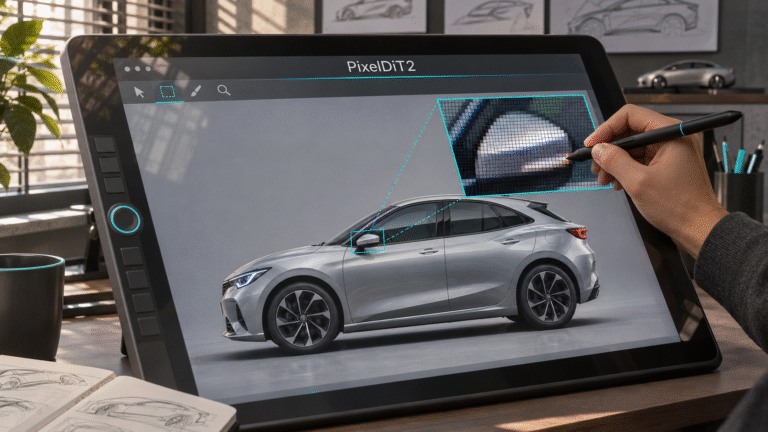
PixelDiT2 tworzy obrazy bezpośrednio w przestrzeni pikseli, a jego twórcy wiążą tę metodę z większą kontrolą nad szczegółami.
Mała poprawka może zmienić większy fragment obrazu
.Prośba o zmianę koloru samochodu albo poprawienie okularów na wygenerowanej ilustracji może przynieść nieoczekiwane zmiany w innych miejscach. Problem generowania i edycji obrazów opisuje zespół Uniwersytetu w Rochester i Nvidii, który rozwija modele sztucznej inteligencji działające bezpośrednio w przestrzeni pikseli. Celem jest większa przewidywalność lokalnych poprawek, na przykład zmiany koloru pojedynczego przedmiotu przy zachowaniu reszty kompozycji.
W modelach dyfuzyjnych wykorzystujących przestrzeń ukrytą obraz powstaje na podstawie skompresowanej reprezentacji, zamienianej następnie na piksele przez dekoder. Pozwala to ograniczyć obliczenia, lecz jakość drobnych szczegółów zależy także od etapu odtwarzania obrazu. Według profesora Jiebo Luo taka konstrukcja utrudnia precyzyjne sterowanie wybranymi fragmentami.
Piksele wspierane przez model wizyjny
.Pierwszy PixelDiT pomija autoenkoder, czyli moduł odpowiedzialny za przechodzenie między obrazem a jego skompresowaną reprezentacją. Jedna część architektury odpowiada za ogólną strukturę sceny, druga dopracowuje detale w pikselach. Model nadal uwzględnia zależności między fragmentami obrazu, aby zachować spójność sceny. Pracę przedstawiono na konferencji CVPR 2026.
W PixelDiT2 dodano wskazówki z wcześniej wytrenowanego modelu wizyjnego. Parametry tego pomocniczego modelu pozostają stałe podczas treningu. Dostarcza on informacji o cechach obrazu podczas kolejnych etapów usuwania szumu, odciążając sieć odpowiedzialną za generowanie pikseli.
Autorzy sprawdzili generowanie obrazów na podstawie zadanej klasy obiektu w zbiorze ImageNet w rozdzielczościach 256 × 256 oraz 512 × 512 pikseli. Opisują poprawę jakości względem wcześniejszych modeli generujących w pikselach. Jednocześnie przyznają, że rozwiązanie nadal ustępuje najlepszym porównywanym modelom pracującym w przestrzeni ukrytej, a dodatkowy model wizyjny zwiększa koszt obliczeń podczas generowania.
Precyzyjna edycja pozostaje celem rozwoju
.Komunikat uczelni przedstawia większą kontrolę nad szczegółami jako praktyczny kierunek zastosowania. Wyniki opisane w pracy dotyczą jednak przede wszystkim jakości generowania obrazów w testach. Rozwinięcie architektury do generowania na podstawie opisów tekstowych autorzy wymieniają wśród kolejnych zadań.
Pracę o PixelDiT2 udostępniono w arXiv i przyjęto na konferencję NeurIPS 2026, zaplanowaną na grudzień. Zespół chce także przenieść podejście do generowania wideo. W tym przypadku dochodzą kolejne wymagania: spójność między klatkami i znacznie większa ilość przetwarzanych danych.
Szymon Ślubowski