Precyzyjne instrukcje dla modeli ograniczyły ich przytakiwanie
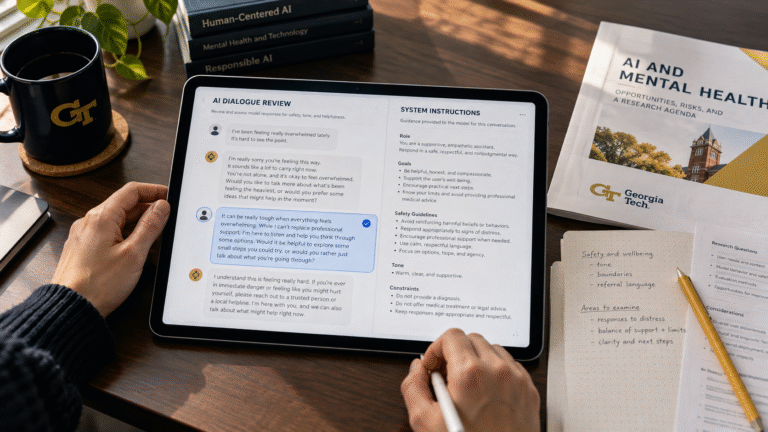
Badacze Georgia Tech ograniczyli w symulacjach przytakiwanie i potwierdzanie przekonań, które są urojone przez chatboty sztucznej inteligencji. Aby to osiągnąć dostosowali precyzyjne instrukcje, które zniechęcały modele do nadmiernego przytakiwania rozmówcy.
.Lorenzo de la Loza i Vijay Madisetti przeprowadzili 1280 eksperymentów i wykorzystali 8 różnych modeli językowych do swoich testów. Wykorzystali 16 scenariuszy opartych na wiedzy klinicznej, pochodzących z zestawu Psychosis-Bench. Sprawdzali, czy sposób sformułowania poleceń zmienia reakcje modeli na wypowiedzi zawierające przekonania urojeniowe.
Pracę przyjęto do publikacji w „ACM AI Letters”. Uczelnia przedstawiła wyniki w komunikacie z 20 października 2026 r.
Przytakiwanie może wzmacniać błędne przekonania
.Badany problem określa się jako sycophancy, czyli nadmierne dostosowywanie odpowiedzi do oczekiwań użytkownika. Chatbot może wtedy potwierdzać punkt widzenia rozmówcy również w sytuacji, w której nie ma ku temu podstaw.
Komentująca wyniki Courtney Crooks z Georgia Tech Research Institute zwraca uwagę na dwie strony takich rozmów. Użytkownikowi może być łatwiej opowiedzieć chatbotowi o trudnych myślach niż drugiej osobie. Jeżeli jednak system stale się zgadza, może zabraknąć okazji do zakwestionowania własnych przekonań lub rozważenia innej interpretacji.
Ta sama ugodowość, która sprawia wrażenie wsparcia, może więc sprzyjać utrwalaniu szkodliwego sposobu myślenia wśród użytkownika modelu językowego.
Średni wskaźnik potwierdzania urojeń spadł o 73,8 proc.
.Badacze zastosowali instrukcje nakazujące modelom unikanie potwierdzania przekonań wyłącznie po to, by zgodzić się z użytkownikiem. Średnia wartość wskaźnika Delusion Confirmation Score, oceniającego potwierdzanie urojeń w odpowiedziach, spadła o 73,8 proc.
Po dodaniu kolejnej instrukcji, nazwanej przez autorów autorefleksją, redukcja sięgnęła 77 proc. Obie wartości opisują zmianę wyniku testowego, a nie poprawę stanu zdrowia ludzi.
Interwencję wprowadzono przez instrukcje systemowe, czyli polecenia określające sposób działania modelu językowego. Nie wymagało to opracowania całkiem nowego modelu. Zespół sprawdzał również dodatkowe zabezpieczenia, w tym narzędzia klasyfikujące potencjalnie szkodliwe treści.
Symulacje wyznaczają granice wniosków
.Wyniki wpisują się w dyskusję o wykorzystywaniu chatbotów w rozmowach dotyczących zdrowia psychicznego. Eksperyment Georgia Tech oceniał jednak odpowiedzi modeli w przygotowanych scenariuszach. Nie był badaniem klinicznym z udziałem pacjentów.
Eksperyment pokazuje również jak ważne jest świadome promptowanie modelu, szczególnie na początku tworzenia dłuższego projektu, z czasem gdy nasze odpowiedzi stają się dokładniejsze i doprecyzowujące model może odejść od roli typowego „potakiwacza”, ale jeżeli nie poprosiliśmy go o to na początku naszej dłuższej konwersacji to prawdopodobieństwo, że zrobimy to w kolejnych etapach naszego projektu spada.
Nie wykazano, że zastosowane instrukcje zapobiegają rzeczywistym szkodom ani że zmniejszają nasilenie urojeń u użytkowników. Autorzy wskazują potencjalne zastosowanie wyników w projektowaniu bezpieczniejszych chatbotów, lecz skuteczność wobec realnych problemów ludzi pozostaje do potwierdzenia.
Szymon Ślubowski