Czy małe języki zachowają własny świat w epoce wielkich modeli AI?
Małe języki w epoce AI potrzebują cyfrowych zasobów, dzięki którym ich słowa, literatura i tradycje będą obecne w nowych technologiach. Fińscy badacze pokazują, jak łączyć ochronę archiwów z budowaniem modeli i sprawdzaniem ich wiarygodności. Stawką jest możliwość przekazywania własnej pamięci oraz dalszego tworzenia kultury we własnym języku.
.Program helsińskiej konferencji „Small Languages, Large Models” z 9–10 listopada 2026 roku łączy zbieranie danych, sprawdzanie modeli i opracowywanie dziedzictwa językowego. Wydarzenie towarzyszy trzydziestoleciu Language Bank of Finland, infrastruktury służącej badaniom nad językiem. Program konferencji, zestawienie omawianych projektów i wystąpień pokazuje, jak blisko znalazły się dziś biblioteka, archiwum i laboratorium informatyczne.
Krister Lindén z Uniwersytetu Helsińskiego w streszczeniu swojego wystąpienia ostrzega przed kulturowym ujednolicaniem i utratą obszarów użycia języków słabiej reprezentowanych w danych. Zwraca uwagę, że przez dziesięciolecia opracowywane zbiory tekstów stają się strategiczną podstawą uczenia, dostrajania i oceniania modeli. W tym ujęciu tradycyjna praca filologiczna nabiera nowego znaczenia.
Polski czytelnik może rozpoznać w tych rozważaniach problem opisany wcześniej na łamach „Wszystko co Najważniejsze” w materiale o AI i języku polskim. Dotyczył on zdolności polszczyzny do zachowania znaczenia w edukacji, pracy intelektualnej i kontaktach z instytucjami. Fińska debata rozszerza tę perspektywę na wspólnoty, których literatura, odmiany mowy i historyczne świadectwa są znacznie słabiej dostępne dla narzędzi cyfrowych.
Małe języki w epoce AI potrzebują własnych zasobów
Określenie języka jako ubogiego w zasoby opisuje stan jego technologicznego opracowania. Obejmuje dostępność tekstów, nagrań, słowników, danych do tłumaczenia oraz przykładów pozwalających rzetelnie oceniać odpowiedzi systemu. Język może mieć rozbudowaną tradycję ustną i wielowiekową historię, a zarazem niewielką reprezentację w zbiorach używanych przez informatyków.
Pratik Joshi i współautorzy już w pracy przedstawionej na konferencji Association for Computational Linguistics w 2020 roku wykazali głęboką nierówność w obecności języków w badaniach i technologiach przetwarzania mowy oraz tekstu. Powiązali tę sytuację z dostępnością zasobów i zainteresowaniem poszczególnymi językami w środowisku naukowym. Ich analiza podważała założenie, że narzędzia deklarowane jako niezależne od języka w podobnym stopniu służą wszystkim wspólnotom.
W praktyce jakość narzędzi może wpływać na wybór języka, w którym człowiek szuka wiedzy, pracuje i zadaje pytania. Jeżeli w jednym języku system pomaga skutecznie, a w drugim wymaga nieustannego poprawiania, użytkownik otrzymuje zachętę do przejścia na rozwiązanie wygodniejsze. Taką możliwość wskazywał również wcześniejszy materiał „Wszystko co Najważniejsze”: język pozostaje obecny w domu, a kolejne zadania poznawcze i zawodowe są wykonywane w innym.
Rozwój technologii przynosi zarazem przykłady poszerzania ich możliwości. W pracy o modelu Poro 34B, opublikowanej w materiałach konferencyjnych w 2025 roku, zespół Rista Luukkonena pokazał korzyści z łączenia fińskiego, angielskiego i języków programowania podczas uczenia jednego systemu. Wyniki wspierały tezę, że odpowiednio zaprojektowana wielojęzyczność może poprawiać działanie modelu w języku o mniejszej ilości danych; zachowanie odrębności językowej może więc korzystać również ze współpracy między językami.
Archiwum staje się częścią infrastruktury przyszłości
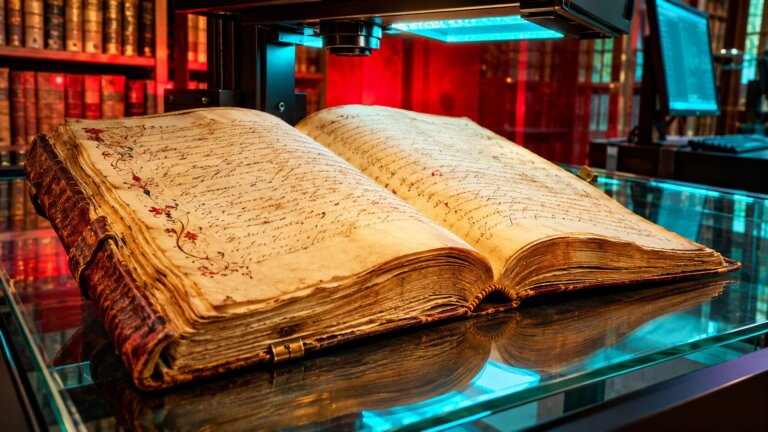
Wśród projektów przedstawianych podczas spotkania w Helsinkach znalazła się cyfrowa kolekcja literatury saamskiej przygotowywana przez Bibliotekę Narodową Finlandii. Samo umieszczenie jej obok narzędzi informatycznych pokazuje kierunek myślenia organizatorów: historyczne zbiory mogą służyć współczesnym badaniom nad językiem. Przygotowanie cyfrowej kolekcji tworzy podstawę dalszej pracy nad dostępnością i opracowaniem tych tekstów.
O skali pracy archiwalnej świadczy odrębna kolekcja Lapponica, udostępniana przez tę samą bibliotekę jako źródło do badań saamskich. Jej opis wymienia 1302 tytuły książek i innych druków, z których 125 jest dostępnych w tej kolekcji w postaci cyfrowej. Zbiór, zapoczątkowany przez Jakoba Fellmana w XIX wieku, obejmuje między innymi elementarze, słowniki, gramatyki, literaturę religijną, beletrystykę i poezję, a także dokumenty dotyczące życia społecznego.
Każdy taki materiał wymaga decyzji o sposobie opracowania i opisania. Skan pozwala zobaczyć stronę, natomiast przeszukiwalny tekst, rozpoznanie odmiany językowej i informacja o pochodzeniu dokumentu otwierają dalsze możliwości badawcze. Dla czytelnika szukającego pojedynczej książki różnica bywa niewielka; dla zespołu porównującego tysiące zapisów stanowi warunek wykonania pracy.
Ważne okazują się więc dwa rodzaje kompetencji: wiedza o kulturze i umiejętność budowania narzędzi. Błędnie odczytane nazwisko, pomylona odmiana języka czy zatarte pochodzenie tekstu mogą przejść z katalogu do kolejnych analiz. Cyfryzacja wymaga więc także zachowania informacji, dzięki którym przyszły odbiorca będzie potrafił ocenić świadectwo.
Dawne pieśni sprawdzają możliwości nowych modeli
Szczególnie wyrazisty przykład dają runosongi, tradycyjne pieśni ludów bałtyckofińskich. Zespół Lidii Pivovarovej w pracy z 2025 roku opisał połączony korpus około 250 tysięcy tekstów, zapisywanych od XVI do XX wieku, zawierający ponad milion różnych form wyrazowych. Materiał obejmuje liczne języki, odmiany regionalne, archaizmy i konwencje poetyckie, a jego opracowanie wykracza poza możliwości jednego współczesnego słownika.
Badacze przygotowali ręcznie opisany zbiór około 200 pieśni, aby sprawdzać, jak duże modele radzą sobie z ustalaniem form podstawowych wyrazów i tłumaczeniem ich znaczeń. Odnotowali zarówno użyteczne możliwości systemów, jak i ich skłonność do wymyślania analiz nieznanych słów oraz wrażliwość na niewielkie zmiany polecenia. Wyniki wskazywały na znaczenie oceny prowadzonej przez specjalistów i starannego projektowania instrukcji.
Uniwersytet Helsiński, przedstawiając w 2026 roku prace grupy FILTER, informował już o uzyskaniu angielskich tłumaczeń i analiz językowych wersów oraz słów w badanym zbiorze runosongów. Według zespołu może to umożliwić szerokie porównywanie elementów stałych i improwizowanych w różnych wykonaniach. Nowa skala analizy otwiera drogę do pytań o sposób, w jaki wykonawcy korzystali ze wspólnego repertuaru i nadawali mu własny kształt.
Przekład na angielski staje się w tej sytuacji pomocniczym sposobem porównywania materiału. Wartość całego przedsięwzięcia pozostaje jednak związana z możliwością powrotu do oryginalnego zapisu, jego języka i historycznego kontekstu. Różnica między wariantami pieśni może przecież być właśnie tym, co badacz chce zrozumieć: śladem lokalnego doświadczenia, pamięci wykonawcy albo zmiany zachodzącej w tradycji.
Płynna odpowiedź wymaga sprawdzenia
Drugim ważnym wątkiem helsińskiej konferencji jest wykrywanie halucynacji, czyli treści generowanych przez model, które brzmią wiarygodnie, choć zawierają zmyślenia lub inne nieuzasadnione uzupełnienia. Problem ten wymaga osobnego sprawdzania w różnych językach. W przypadku historycznego materiału językowego samo rozpoznanie, co jest błędem, może wymagać rzadkich kompetencji i pracy z trudno dostępnym źródłem.
Organizowany przez badaczy związanych z Helsinkami projekt Mu-SHROOM w edycji opisanej w 2025 roku obejmował 14 języków. Jego uczestnicy oznaczali konkretne fragmenty odpowiedzi zawierające halucynacje, a autorzy analizy wskazali różnice między językami oraz znaczne rozbieżności między ludźmi oceniającymi te same treści. Tak więc oprócz budowania modeli potrzebna jest infrastruktura ich niezależnego sprawdzania.
Szerszy wymiar tej zmiany opisywał na łamach „Wszystko co Najważniejsze” prof. Alexei Grinbaum w rozważaniach o mowie maszyn. Zwracał uwagę, że technologie odbierają człowiekowi wyłączność na wytwarzanie wypowiedzi, a generowane opowieści zaczynają realnie oddziaływać na ich odbiorców. Przy ochronie małych języków oznacza to potrzebę rozpoznawania pochodzenia tekstu: odróżnienia zachowanego świadectwa od późniejszej rekonstrukcji i od treści wygenerowanej na podstawie podobieństw.
Możliwości tłumaczenia rozwijają się przy tym szybko, o czym świadczy projekt No Language Left Behind, opisany w „Nature” w 2024 roku. Jego zespół przedstawił model obejmujący 200 języków i ocenę ponad 40 tysięcy kierunków przekładu, wykorzystującą także pracę ludzi. Taki wynik dokumentuje postęp w określonym zadaniu, podczas gdy rozpoznawanie miejscowych aluzji, odmian mowy i znaczenia historycznego tekstu wymaga dalszych, odrębnych sprawdzianów.
Kto decyduje o wykorzystaniu pamięci wspólnoty?
Udostępnianie dawnych zbiorów prowadzi również do pytania o prawo do decydowania o ich przyszłym użyciu. Pieśń, zapis rozmowy czy opowieść rodzinna mają autorów, wykonawców i społeczności, dla których zachowują określone znaczenie. Przygotowanie danych do badań wymaga ustalenia warunków dostępu, sposobu przypisania autorstwa oraz odpowiedzialności za dalsze wykorzystanie materiału.
Taką perspektywę rozwijają zasady CARE dotyczące zarządzania danymi ludów rdzennych, opisane przez Stephanie Russo Carroll i współautorów w „Data Science Journal” w 2020 roku. Obejmują wspólne korzyści, prawo do kontroli, odpowiedzialność i etykę, a w centrum stawiają relację między danymi a ludźmi, których one dotyczą. Ich autorzy wskazują, że rozwój badań powinien wzmacniać zdolność wspólnot do korzystania z własnych zasobów i wpływania na zasady ich używania.
W przypadku narzędzia językowego takie podejście oznaczałoby udział użytkowników języka w określaniu jego zadań i ocenie działania. Innych materiałów potrzebuje nauczyciel, innych badacz dawnej poezji, a jeszcze innych osoba przygotowująca współczesny tekst dla lokalnej społeczności. Sens inwestycji ujawnia się w możliwości wykonywania tych konkretnych prac i w korzyściach, które wracają do wspólnoty.
Podobny kierunek przyjmuje UNESCO w mapie drogowej dotyczącej wielojęzyczności w epoce cyfrowej, ogłoszonej w 2025 roku. Dokument łączy rozwój technologii z udziałem społeczności w podejmowaniu decyzji, szkoleniem specjalistów oraz budową odpowiedniej infrastruktury. Ochrona różnorodności językowej zostaje w ten sposób powiązana z długotrwałą pracą instytucji, które potrafią przechowywać zasoby, udostępniać je i odpowiadać za ich jakość.
Język potrzebuje kolejnych pokoleń rozmówców
Prof. Marta Rakoczy w opublikowanym we „Wszystko co Najważniejsze” tekście o sporach o polszczyznę przypominała, że język jest dobrem wspólnym i przestrzenią ukształtowaną przez historię. Opisywała go przez metaforę miasta, w którym pozostają ślady przemian i różne sposoby zamieszkiwania. Ta perspektywa pozwala dostrzec znaczenie lokalnych odmian, odmiennych rejestrów i słów przechowujących doświadczenia poszczególnych grup.
W odniesieniu do AI prowadzi ona do pytania o cel technologicznego porządkowania języka. Ujednolicenie zapisu może ułatwić wyszukiwanie, a przekład otworzyć zbiór dla odbiorców z innych krajów, lecz badanie dziedzictwa wymaga równoczesnego zachowania różnic i możliwości odtworzenia źródła. Dobre narzędzie powinno pomagać użytkownikowi odnaleźć tekst oraz zrozumieć, w jaki sposób otrzymał proponowany wynik.
Z helsińskiej debaty można wyprowadzić praktyczny wniosek: przyszłość języka będzie zależeć także od jakości współpracy bibliotek, szkół, uczelni i jego codziennych użytkowników. Modele mogą ułatwiać badanie dawnych zapisów, poszerzać dostęp do literatury i wspierać przygotowywanie nowych materiałów. Ich wartość dla kultury warto mierzyć tym, czy pomagają ludziom czytać, rozmawiać i tworzyć we własnym języku.
Mały język zachowuje przyszłość wraz z kolejnymi osobami, które chcą posługiwać się nim w nowych sytuacjach. Cyfrowe archiwum może przybliżyć im głosy wcześniejszych pokoleń, a odpowiednio sprawdzone narzędzie pomóc podjąć z nimi rozmowę. Własny świat trwa wtedy, gdy pamięć staje się punktem wyjścia do następnych wypowiedzi.
Karolina Jaszowiecka